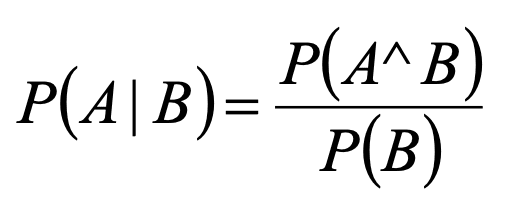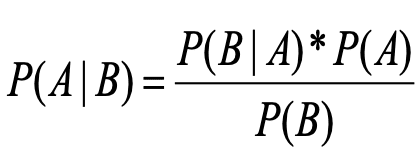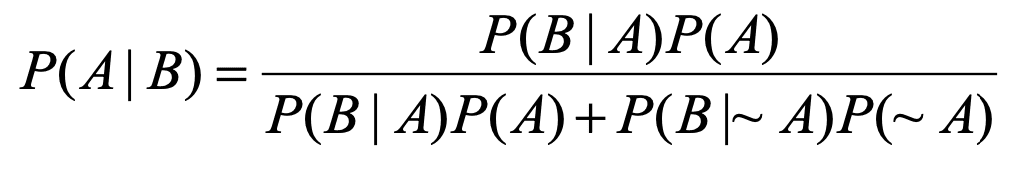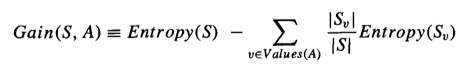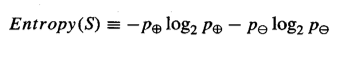Hari ini saya diminta untuk memperbaiki usulan penelitian. Jadi ada transisi web penelitian kemdikbud dari simlibtabmas ke bima. Di menu substansi usulan ada diminta memilih kelompok makro riset. Ada 7 pilihan disana:
Kelompok riset terapan berbasis sumber daya alam
Kelompok riset maju berbasis sumber daya alam
Kelompok riset terapan manufaktur
Kelompok riset maju manufaktur
Kelompok riset teknologi tinggi
Kelompok riset rintisan terdepan
Kelompok riset lainnya
Kalo berdasarkan panduan, pilihan kelompok makro riset mengacu pada perpres no 38 tahun 2018. Di perpres itu penjelasan begini:
Kelompok Riset terapan berbasis sumber daya alam mencakup kajian Riset yang menghasilkan luaran berbasis eksplorasi dan pemanfaatan kekayaan sumber daya alam tanpa mengubah sifat asli materialnya. Contohnya teknologi pertanian, teknologi proses pasca panen, budidaya perikanan, suplemen dan herbal, dan teknologi Penambangan.
Kelompok Riset maju berbasis sumber daya alam mencakup kajian Riset dengan melakukan rekayasa lanjut sehingga mengubah sifat asli materialnya Contohnya rekayasa genetika untuk penciptaan bibit unggul, ekstrak senyawa untuk obat-obatan, dan teknologi pengolahan mineral
Kelompok Riset terapan manufaktur mencakup kajian Riset rekayasa pendukung proses manufaktur tanpa mengubah sifat asli materialnya. Contohnya teknologi pengemasan makanan proses kimia, dan pengolahan mineral jarang
Kelompok Riset maju manufaktur mencakup kajian Riset rekayasa lanjut pendukung proses manufaktur dengan mengubah sifat asli materialnya Contohnya bioplastik yang bisadikonsumsi, nanomaterial untuk kemasan hidrogen, material baru untuk magnet permanen, dan teknologi informasi
Kelompok Riset teknologi tinggi mencakup kajian Riset yang bisa diaplikasikan tetapi membutuhkan penguasaan teknologi lintas disiplin. Contohnya teknologi roket, radar, dan pengembangan rudal.
Kelompok Riset rintisan terdepan mencakup kajian Riset yang belum bisa langsung diaplikasikan, serta ditujukan untuk menjawab keingintahuan ilmiah. Contohnya fisika energi tinggi, eksplorasi bawah laut dalam, eksplorasi antariksa, dan matematika lanjut
Buat para peneliti, dosen atau mahasiswa biasanya perlu untuk ngebaca paper penelitian. Ada banyak banget paper penelitian, sehingga kita kadang bingung untuk milih mana yang musti dibaca dulu. Kemaren saya nemu tools connected paper. Tools ini bisa dipake buat ngeliat keterhubungan antara paper-paper yang ada.
Disana kita tinggal masukin sebuah tema (misalnya malware detection) tar dia akan nampilin beberapa pilihan paper penting tentang tema tersebut. Setelah itu dia akan nampilin keterhubungan paper itu dengan paper lainnya.
Bisa juga kita masukin Doi dari sebuah paper. Dengan tool ini kita bisa lihat paper mana aja yang paling berpengaruh pada sebuah tema. Kalo mahasiswa lagi nyari referensi paper tentang sebuah tema, bisa juga pake tool ini.
Semuanya ditampilkan dalam bentuk grafik. Buat nampilin grafik keterhubungan paper ini konon tool ini melakukan analisa terhadap 50 ribu paper. Tools ini dikembangkan oleh Alex Eita dkk.
Kemaren saya diminta membandingkan kemiripan (similarity) dari 2 paper. Jadi ceritanya paper ini satunya sudah disubmit di proceeding conference, satu lagi di jurnal. Paper yang dijurnal adalah versi extended (pengembangan dari paper yang di proceeding. Similarity ini penting banget karena takutnya paper2 ini nanti dicurigai sebagai plagiarisme alias nyontek. Berhubung kampus masih langganan ithenticate, jadi saya coba cek similaritynya pake ithenticate. Ithinticate ini adalah salah satu layanan pengujian plagiarisme, mirip kayak turnitin.
Cuman biasanya saya pake ithenticate untuk nguji similarity dokumen dengan dokumen lainnya di internet. Ternyata software ini bisa dipake juga untuk nguji similarity 2 dokumen. Caranya kayak gini
Nanti muncul pilihan Report & Repository Options, bisa pilih salah satu antara to Document Repository & Generate Report atau to Document Repository Only.
Kemudian masukan nama yang bikin dokumen Author First Name, Author Last Name dan judul Document Title untuk file pertama
Kemudian upload filenya di menu Choose File
Pilih Add another file untuk mengupload file kedua
Ulangi langkah ke 3-5 untuk dokumen kedua yang mau kita bandingkan
Klik Upload
Trus nanti si ithenticate akan memproses dan bakal muncul hasil analisa similaritynya. Klo udah ada hasil analisanya klik persentase similarity dari dokumen kedua
Setelah itu akan keluar report di The iThenticate Document Viewer
Di panel sebelah kanan pilih Your Indexed Documents
Klik angkanya
Klik Full Source View di kanan atas bagian summary
Perbandingan similaritynya akan tampil
Oiya jangan lupa untuk remove dokumennya dari index, biar aman. Kalo gak diremove tar dia tetep dibandingin similaritynya dengan dokumen lain. Caranya klik icon Edit di dokumennya
Pada panel samping Document Information sebelah tulisan Indexed, klik on (remove). Trus klik OK.
Info tentang dokumen kemudian bakal diupdate sama ithenticate jadi gak keindeks.
Saya lagi belajar tentang aksioma probabilitas. Di matematika teori dapat dikembangkan dari aksioma. Aksioma itu adalah aturan dasar atau prinsip yang dijadikan sandaran teori matematika berikutnya. Dari aksioma diturunkan menjadi teori berdasarkan bukti (proof) melalui logika deduktif.
Contohnya dalam teori probabilitas, kita bisa turunkan keseluruhan teori hanya dari 3 aksioma. Pendekatan aksioma ini berguna misalnya untuk memastikan bahwa sebuah teori konsisten dan tidak bertentangan dengan teori lainnya. Aksioma dapat juga kita program di komputer, dan digunakan untuk menyelesaikan permasalahan riil lainnya.
Selain teori dan aksioma, biasanya ada juga definisi. Definisi membangun konsep baru dari konsep yang sudah ada. Konsep yang sudah ada pada axioma. Definisi tidak memberikan asumsi baru ke teori, namun menjelaskan aksioma.
Jadi ada 3 macam pernyatan.
Aksioma: Prinsip dasar yang kita terima kebenarannya
Definisi: Pernyataan yang mengenalkan konsep baru
Teori: Pernyataan yang diturunkan dari aksioma dan definisi
3 Aksioma Probabilitas
Teori Probabilitas memiliki 3 aksioma, yaitu:
Normality: 0<=P(A)<=1
Tautology rule: P(True) = 1 ; P(False)=0
Additivity rule : P(A or B) = P(A) + P(B) – P(A and B)
Dari 3 aksioma ini kemudian dapat kita turunkan berbagai teori probabilitas. Yang pertama adalah Rule Negasi:
P(A’)=1-P(A)
Contradiction Rule
Bila A adalah kontradiksi maka P(A)=0
Conditional Probability
Multiplication Rule:
Bila P(B)>0 maka P(A and B) = P(A|B) P(B)
Equivalent Rule:
Jika A & B logical equivalent maka P(A)=P(B)
General Addition Rule
P(A or B) = P(A) + P(B) – P(A and B)
Total Probability rule:
Jika 0< P(B) < 1 maka P(A) = P (A|B) P(B) + P(A|B’) P(B’)
Teori Bayes
Versi Panjang:
Independensi:
A independen dari B jika P(A|B) = P(A) dan P(A) > 0
Jika A independen dari B, maka P (A and B) = P(A) P(B)
Jika A independen dari B, maka B independen dari A
Dalam kuliah machine learning ada dibahas tentang Occam Razor principle. Occam razor yang dimaksud adalah prinsip law of parsimony yang disampaikan oleh Sir William of Ockham (1287-1347), yaitu “plurality must never be posited without necessity” . Maksudnya bila ada beberapa hypothesis yang bisa diambil untuk menyelesaikan sebuah masalah (prediksi) yang sama, hipotesis yang lebih sederhana lebih diutamakan. Atau dengan kata lain, “penjelasan yang lebih mudah adalah yang terbaik”.
Dalam konteks decision tree, prinsip ini digunakan untuk mencoba menyederhanakan tree untuk menghindari masalah overfitt. Bila ada beberapa pilihan tree yang menghasikan prediksi yang sama (atau eror klasifikasi yang sama), maka sebaiknya kita memilih tree yang lebih sederhana.
Pertanyaan berikutnya apa yang dimaksud dengan pohon yang sederhana. Tentunya bila kita harus memperhatikan depth dari tree, atau kedalaman tree. Maksudnya lebih banyak cabang dari tree maka lebih kompleks tree tersebut.
Ada 2 pendekatan yang digunakan untuk membuat tree yang lebih sederhana. Yang pertama adalah early stopping, atau berhenti lebih awal. Maksudnya daripada membuat tree yang lebih panjang (dalam) atau lebih banyak cabang, lebih baik berhenti lebih awal untuk menghindari overfitting. Sehingga akan didapatkan tree yang lebih sederhana. Pendekatan ini menyebutkan bahwa kita dapat berhenti bila proses cabang tidak lagi signifikan secara statistik.
Pendekatan lain adalah pruning. Yaitu membangun tree yang dalam kemudian memotong beberapa cabang di bawah seperti beberapa keputusan (decision) yang tidak penting.
Untuk memilih pohon terbaik digunakan juga tiga pendekatan:
menghitung performa pada training data
menghitung performa pada dataset validasi yang terpisah
MDL: melakukan minimalisasi: size (tree) + size (misclassifications(tree))
Hari ini ada anak bimbingan yang sidang (michelle) dia ngambil tema forensik di Android. Kasusnya di salah satu apps e-payment. Biasanya untuk android musti di root dulu, supaya bisa diakses databasenya. Kemudian mulai dicloning data2nya. Biasanya di folder /root/data/data/ disana ada banyak folder apps. Tinggal dicari folder appsnya. Kemudian tinggal dicari file .db nya. File .db ini kemudian coba dibuka di sql lite. Tentunya dilakukan dulu pengujian integrity test.
Cuman menariknya apps e-payment ini dia pake firebase, sehingga file .db nya hanya sedikit. Jadi agak sedikit ribet untuk proses forensiknya beda dengan apps android lainnya. Firebase ini nyimpen databasenya di cloud. Hasil googling dan nanya2 ada beberapa alternatif untuk ngatasin kasus ini, misalnya melakukan replica aplikasi atau bikin skrip yg nge-patch data dan alamat point Firebase menggunakan API key.nya. Atau ada juga alternatifmelakukan intercept aplikasinya. Untuk meakukan ini SSL pinning nya musti di bypass dulu. Atau bisa juga kita lakukan analisa pake mobSF.
Anaknya dah panik juga karena sampe menjelang sidang, masih belum dapat artefak transaksi. Akhirnya kita bisa coba pendekatan lain, melalui data-data lainnya selain file .db bisa dipelajari dan ditemukan adanya transaksi. Lumayan seru juga sidang hari ini.
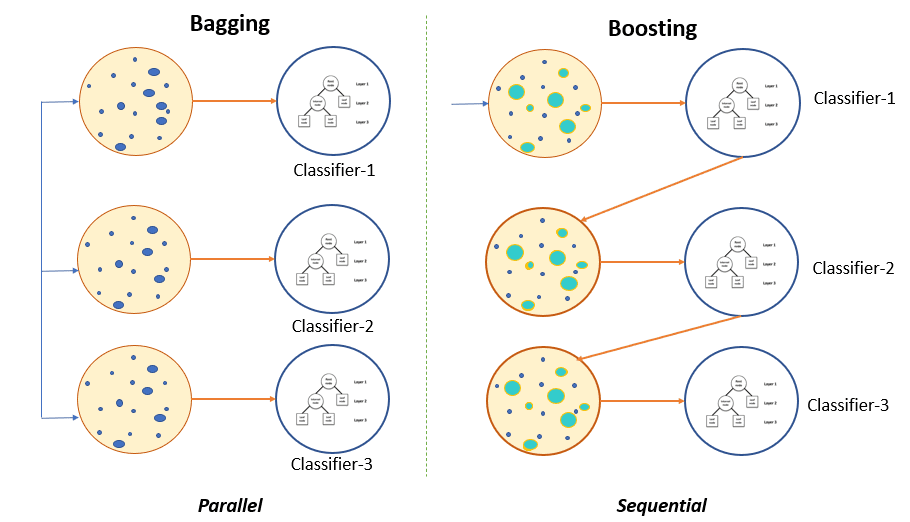
Saya lagi baca2 tentang metode ensemble learning. Ensemble learning melakukan kombinasi beberapa algoritma learning untuk meningkatkan performa. Ada dua metode yang populer di model ensemble, yaitu bagging dan boosting.
dari https://www.pluralsight.com/guides/ensemble-methods:-bagging-versus-boosting
Bagging
Bagging atau bootstrap aggregation adalah metode ensemble yang melakukan training beberapa classifier secara terpisah (paralel). Hasil dari training klasifier2 ini kemudian dikombinasi untuk menghasilkan prediksi akhir dari sistem.
Bagging diajukan oleh Breiman pada tahun 1994. Ketika kita melakukan training sebuah mode, hasil prediksi dan parameter modelnya tergantung pada ukuran data dan komposisi data yang digunakan pada training. Pada beberapa training bisa terjadi overfitting, dimana hasil prediksi dan model akhir berbeda jauh. Pada kasus ini, parameter model variance dan prediksi berbeda jauh. Dengan teknik bagging ini dapat digunakan untuk mengurangi model variance dan membuat prediksi lebih independen terhadap noise.
Model bagging yang populer diantaranya adalah random forest. Random forest adalah tipe khusus dari decision tree ensemble. Metrik yang digunakan untuk memprediksi eror dari random forest adalah out-of-bag error (OOB). OOB adalah rata-rata eror prediksi yang dihitung ddari semua sampel
Boosting
Bossting menggunakan beberapa model secara sequensial untuk meningkatkan performa. Beberapa weak model disusun untuk meningkatkan hasil prediksi. Weak Model yang dimaksud adalah model dengan parameter yang sedikit dan ditraining hanya dengan beberapa iterasi, contohnya shallow decision tree. Model lemah ini umumnya hanya menghasilkan performa yang baik pada data tertentu saja. Dengan boosting ditambahkan model lemah lainnya dengan tujuan pada eror dari model sebelumnya.
Kelebihan metode ini adalah memori. Model yang ditraining secara sequensial membutuhkan memori yang lebih sedikit, dibandingkan random forest yang melakukan training beberapa strong model secara bersamaan.
Keuntungan lainnya adalah spesialisasi pada weak model. Model2 ini secara umum tidak menghasilkan performa yang baik. Namun menghasilkan performa yang baik pada beberapa tipe data. Setiap model dapat di susun weight nya pada proses decision.
Boosting digunakan pada task prediksi numerik. Bisa juga digunakan untuk melakukan klasifikasi probabilitas kelas sebagai nilai prediksi. Training diakhiri ketika jumlah iterasi maksimal telah dicapai atau eror model terlalu besar. Boosting umumnya digunakan pada weak model. Teknik boosting cukup sensitif terhadap noise dan outlier, yaitu overfitting.
Gradient boosted trees adalah model ensemble yang menggabungkan beberapa model regression trees menjadi model yang kuat.
Pada tulisan sebelumnya telah dibahas tentang Decision Tree, dengan contoh algoritma ID3. Sekarang akan dibahas tentang algoritma CART. Klo ID3 menggunakan perhitungan Information Gain untuk menentukan atribut yang dipilih, di CART digunakan Gini index.
Contohnya misalnya kita masih menggunakan dataset berikut tentang cuaca yang cocok untuk main tenis:
Gini index adalah metrix yang digunakan untuk klasifikasi di CART. Gini menyumpan kuadrat probabilitas dari setuap kelas. Rumusnya :
Outlook
Untuk Outlook ada 3 nilai yaitu sunny, overcast dan rain
Dari tabel kita bisa lihat untuk sunny ada 5 yang terdiri dari 2 yes dan 3 no
Sementara untuk overcast ada 4 yang terdiri dari 4 yes dan 0 no
dari perhitungan kita mendapatkan gini outlook=0,342; temperatur=0,439; humidity=0,367 dan wind=0,428 ; berbeda dengan ID3 yang memilih Gain terbesar, disini kita pilih Gini terkecil yaitu outlook.
sehingga diperoleh rootnya adalah:
outlook
–sunny
–overcast–yes
–rain
Dari tabel terlihat untuk overcast hanya menghasilkan yes, sehingga tidak perlu kita hitung lagi cabangnya
langkah selanjutnya adalah menentukan cabang dari sunny
sunny
tabel untuk sunny adalah sebagai berikut:
Selanjutnya kita hitung nilai gini untuk temperatur dari tabel diatas:
sunny-temperatur
temperatur ada 7 dengan 3 nilai Hot, mild dan cool
Hot ada 2 dengan 0 yes dan 2 no
Cool ada 1 dengan 1 yes dan 0 no
mild ada 2 dengan 1 yes dan 1 no
Gini(outlook=sunny dan temp=hot)=1-(0/2)^2-(2/2)^2=0
Dari perhitinugan didapat gini temperatur=0,2; humidity=0; dan wind=0,466. Nilai terkecil adalah humidity. Dari tabel humidity terdapat dua cabang yaitu high dan normal. Dari nilai high diperoleh klasifikasi yang semuanya bernilai no sedangkan normal selalu yes
Sehingga kita dapatkan
outlook
–sunny
—-humidity
——-high=no
——-normal=yes
–overcast–yes
–rain
Sekarang tinggal menghitung cabang dari rain:
Rain
Rain memiliki tabel berikut:
Selanjutnya kita hitung gini untuk temperatur:
rain – temperatur
hanya ada 2 nilai temperatur yaitu mild dan cool, dengan total ada 5 instance
Decisition Tree Learning adalah salah satu metode yang cukup banyak digunakan pada mesin learning. Ada beberapa algoritma yang dapat digolongkan sebagai Decision Tree (DT), yaitu ID3, ASSISTANT dan C4.5.
DT adalah metode untuk memprediksi nilai diskret dari fungsi target. Fungsi yang dipelajari direpresentasikan dalam bentuk decision tree. Tree dapat direpresentasikan juga dengan rules if-then. DT melakukan klasifikasi menggunakan sebuah tree, mulai dari root, node sampai ke leaf (daun). Setiap node melakukan pengujian atribute tertentu, dan mengikuti cabang dari tree ke bawah sampai daun.
Contoh kasus adalah tabel decision tree tentang klasifikasi cuaca yang cocok untuk main tenis. Dengan 3 fitur yaitu: outlook (ramalan cuaca), Humidity (Kelembapan udara) dan Kecepatan Angin.
Outlook memiliki tiga cabang yaitu: sunny (cerah), Overcast (mendung), Rain (Hujan)
Humidity: ada high dan normal
Wind: Strong dan weak
Secara umum DT cocok untuk permasalahan dengan karakteristik berikut:
Kondisi dapat digambarkan dengan sepasang nilai atribut (karakter) tertentu.
Fungsi target memiliki nilai diskrit
Diperlukan Hipotesis yang logis
Training data yang mengandung noise, atau data dengan nilai yang hilang
Contohnya penggunaan: diagnosa data medis, analisa resiko kredit,
Algoritma dasar yang digunakan untuk DT adalah ID3 yang diteliti oleh Quinlan pada tahun 1986, dan kemudian dikembangkan menjadi C4.5 juga oleh Quinlan tahun 1993.
Pertanyaan pertama adalah atribut apa yang dipilih menjadi root? Untuk menentukannya, setiap atribut diuji secara statistik untuk menentukan seberapa baik atribut tersebut melakukan klasifikasi data training. Atribut terbaik kemudian dipilih menjadi root. Kemudian cabangnya dipilih lagi berdasarkan atribut mana yang terbaik dst.
Untuk menentukan atribut mana yang terbaik digunakan information gain. Information gain mengukur seberapa baik atribut tersebut memisahkan data berdasarkan klasifikasi yang diinginkan.
Untuk mendapatkan information gain, kita harus mengukur entropy terlebih dahulu. Entropy adalah ukuran impurity (keteracakan) dari data
Contoh dari tabel tentang Cuaca yang baik untuk main tenis:
Kita hitung nilai Gain dengan rumus berikut:
dengan rumus entropi:
diperoleh nilai Gain berikut:
Nilai Gain tertinggi adalah Outlook, sehingga outlook kita pilih menjadi root.
Kemudian untuk memilih cabang dari sunny harus dihitung lagi gain terbaik sebagai berikut:
Karena nilai gain tertinggi adalah humidity maka dipilih cabang dari sunny adalah humidity. kemudian dilakukan perhitungan lagi sehingga diperoleh Decision Tree akhir adalah sebagai berikut:
Contoh video yang menjelaskan tentang merancang decision tree:
Sampai disini dulu. semoga Bermanfaat!
referensi:
Mitchell, Tom Michael. The discipline of machine learning. Vol. 9. Pittsburgh: Carnegie Mellon University, School of Computer Science, Machine Learning Department, 2006
Berikut ini contoh dari learning task T, dengan pengukuran performance P, berbasis pengalaman E.
T: Bermain catur
P: Persentase game yang dimenangkan
E: Pengalaman Berlatih melawan diri sendiri
T: Pengenalan kata dari tulisan tangan
P: Persentasi jumlah kata yang berhasil diklasifikasi dengan benar
E: Database gambar-gambar kata dari tulisan tangan yang telah diberi label oleh manusia
T: Kendali otomatis mobil pada jalan 4 lajur menggunakan sensor
P: Jarak tempuh rata-rata hingga terjadi eror menurut penilaian (orang)
E:Urutan gambar-gambar dan perintah kemudi yang direkam ketika mengamati pengemudi orang
T: Kategorisasi pesan email sebagai spam atau legitimate (bukan spam)
P: Persentasi pesan email yang diklasifikasikan dengan benar
E: Database email, dengan label dari orang
Beberapa contoh teknologi machine learning:
Autonomous car
Deteksi objek
Labeling objek pada gambar
Speech recognition
Contoh task Data mining:
Klasifikasi kedaruratan seorang pasien hamil dari data medis dengan task data mining.
Diketahui: data 9714 pasien, masing-masing menjelaskan status kehamilan pasien. Yang terdiri dari 215 fitur. Seperti:
kehamilan pertama? (yes/no)
Anemia?(y/n)
diabetes?(y/n)
proses kelahiran sebelumnya prematur? (y/n)
hasil ultrasound? (normal/abnormal)
operasi c-section?
emergency c-section?
Lakukan prediksi pasien yang memiliki resiko tinggi untuk Emergency Cesarean section!
Hasil data mining, dari 18 rules disimpulkan bahwa:
If tidak ada kelahiran sebelumnya yang normal, dan hasil ultrasound trismester 2 tidak normal dan Malpresentation pada saat admisi, Then: Kemungkinan emergency c-section adalah 0,6 ; dari data training 26/41=0,63 dari data tes 12/20= 0,6
Contoh kasus lainnya adalah Analisa resiko Pinjaman.
Dari data seorang pelanggan pada 3 waktu berbeda berikut ini:
Tahun kredit
Jumlah pinjaman
besar Pemasukan
Punya rumah?
Akun ilegal?
Apakah pelanggan yang profitable?
Dari data tersebut bisa dibuat rules untuk memprediksi apakah pelanggan ini profitable atau beresiko.
Begitu juga dari data pembelian pelanggan dapat dipelajari polanya dan diprediksi pembelian berikutnya serta strategi customer retention.
Sampai disini dulu. Insyaallah nanti akan saya lanjutkan pada tulisan berikutnya. Semoga bermanfaat!